Turbo MLX (github.com/rinste/turbo-mlx) คือแอปพลิเคชัน Native macOS ฟรีและ Open-Source (MIT License) ที่พัฒนาด้วยภาษา Swift ล้วน ผสานเข้ากับเฟรมเวิร์ก Apple MLX สำหรับชิปตระกูล Apple Silicon (M1 ขึ้นไป) เพื่อใช้ สร้างภาพ แก้ไขภาพ ขยายความละเอียด (Upscale 4x) ทำวิดีโอพร้อมเสียง ทำเพลง และสร้างเอฟเฟกต์เสียง + โมเดล 3D GLB บนเครื่อง Mac ของคุณเอง 100% โดย ไม่ต้องติดตั้ง Python ไม่ต้องพิมพ์คำสั่ง Terminal ไม่ต้องสมัครสมาชิก และไม่เสียค่าเครดิตแม้แต่บาทเดียว
📺 ข้อมูลอ้างอิง & ลิงก์ดาวน์โหลดจากเจ้าของโปรเจกต์ (Sten)
- วิดีโอต้นฉบับ: Creative Local MLX AI Image & Video Models for macOS — ช่อง Sten
- ดาวน์โหลดแอปฟรี (
.dmgล่าสุด v1.11): Turbo-MLX-1.11.dmg (macOS 15+, Apple Silicon M1 ขึ้นไป, RAM 16 GB+) - Source Code บน GitHub: github.com/rinste/turbo-mlx (MIT License • Swift 100%)
- เครื่องมือเสริมสาย Cloud Canvas ในคลิป: node-composer.studio (Node-based workflow จ่ายตามจริงไม่บวก Markup และเก็บไฟล์ในเครื่อง)
1. เบื้องหลังการสร้าง: เผาเครดิต Claude Code เกือบ $250 สู่แอป macOS เต็มระบบ
ผู้สร้าง (Sten) เล่าในเปิดคลิปว่าเขาได้รับเครดิต Claude Code มูลค่า $250 (ใช้ไปจริง $243.27 / กว่า 11 ล้าน tokens จนถึง Build #22) เพื่อสร้างแอปสร้างภาพและวิดีโอ AI บน Mac ให้ เรียบง่ายและรีดประสิทธิภาพสูงสุด โยนความยุ่งยากของการเซต Environment ทิ้งไปทั้งหมด แค่โหลด .dmg ลากลง Applications แล้วเปิดใช้งานได้ทันที
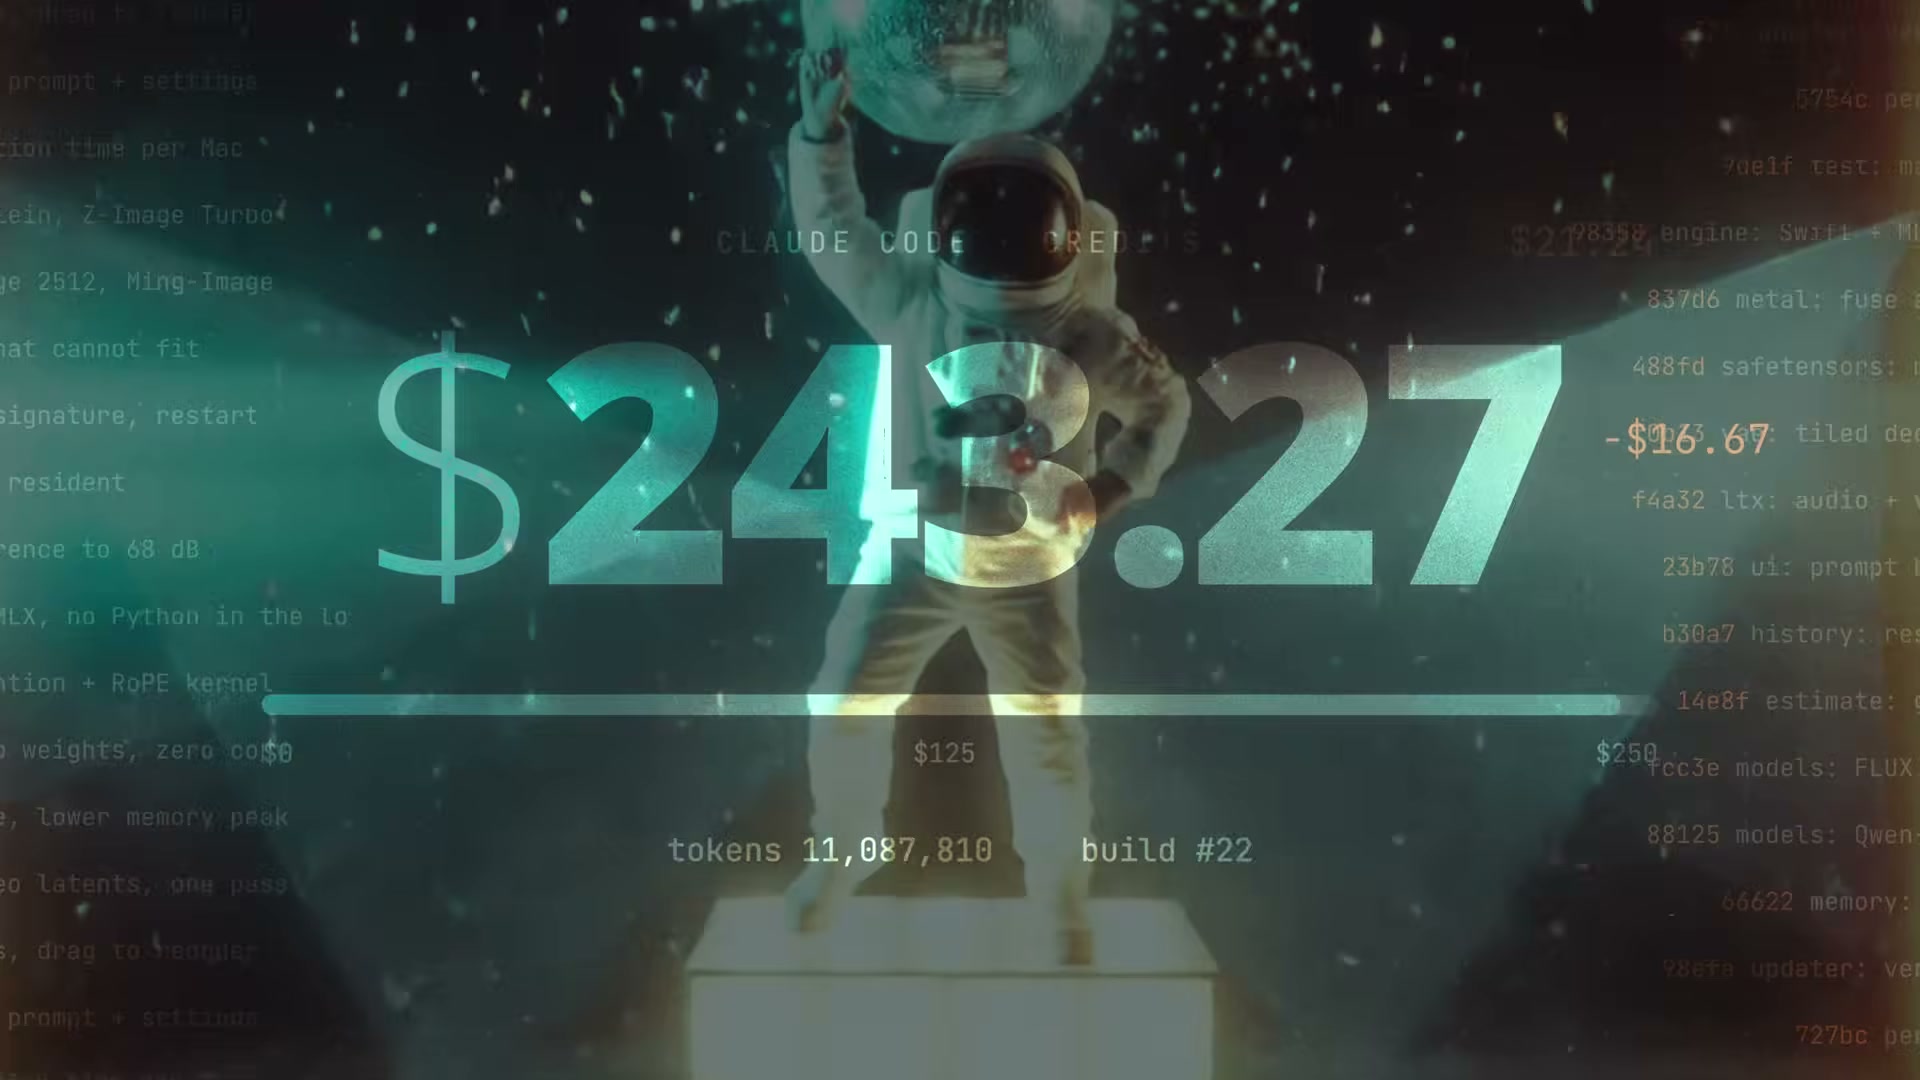
ภาพจากคลิป (00:05): เบื้องหลังการสร้าง Turbo MLX ด้วย Claude Code (98358 engine: Swift + MLX, f4a32 ltx: audio + video)
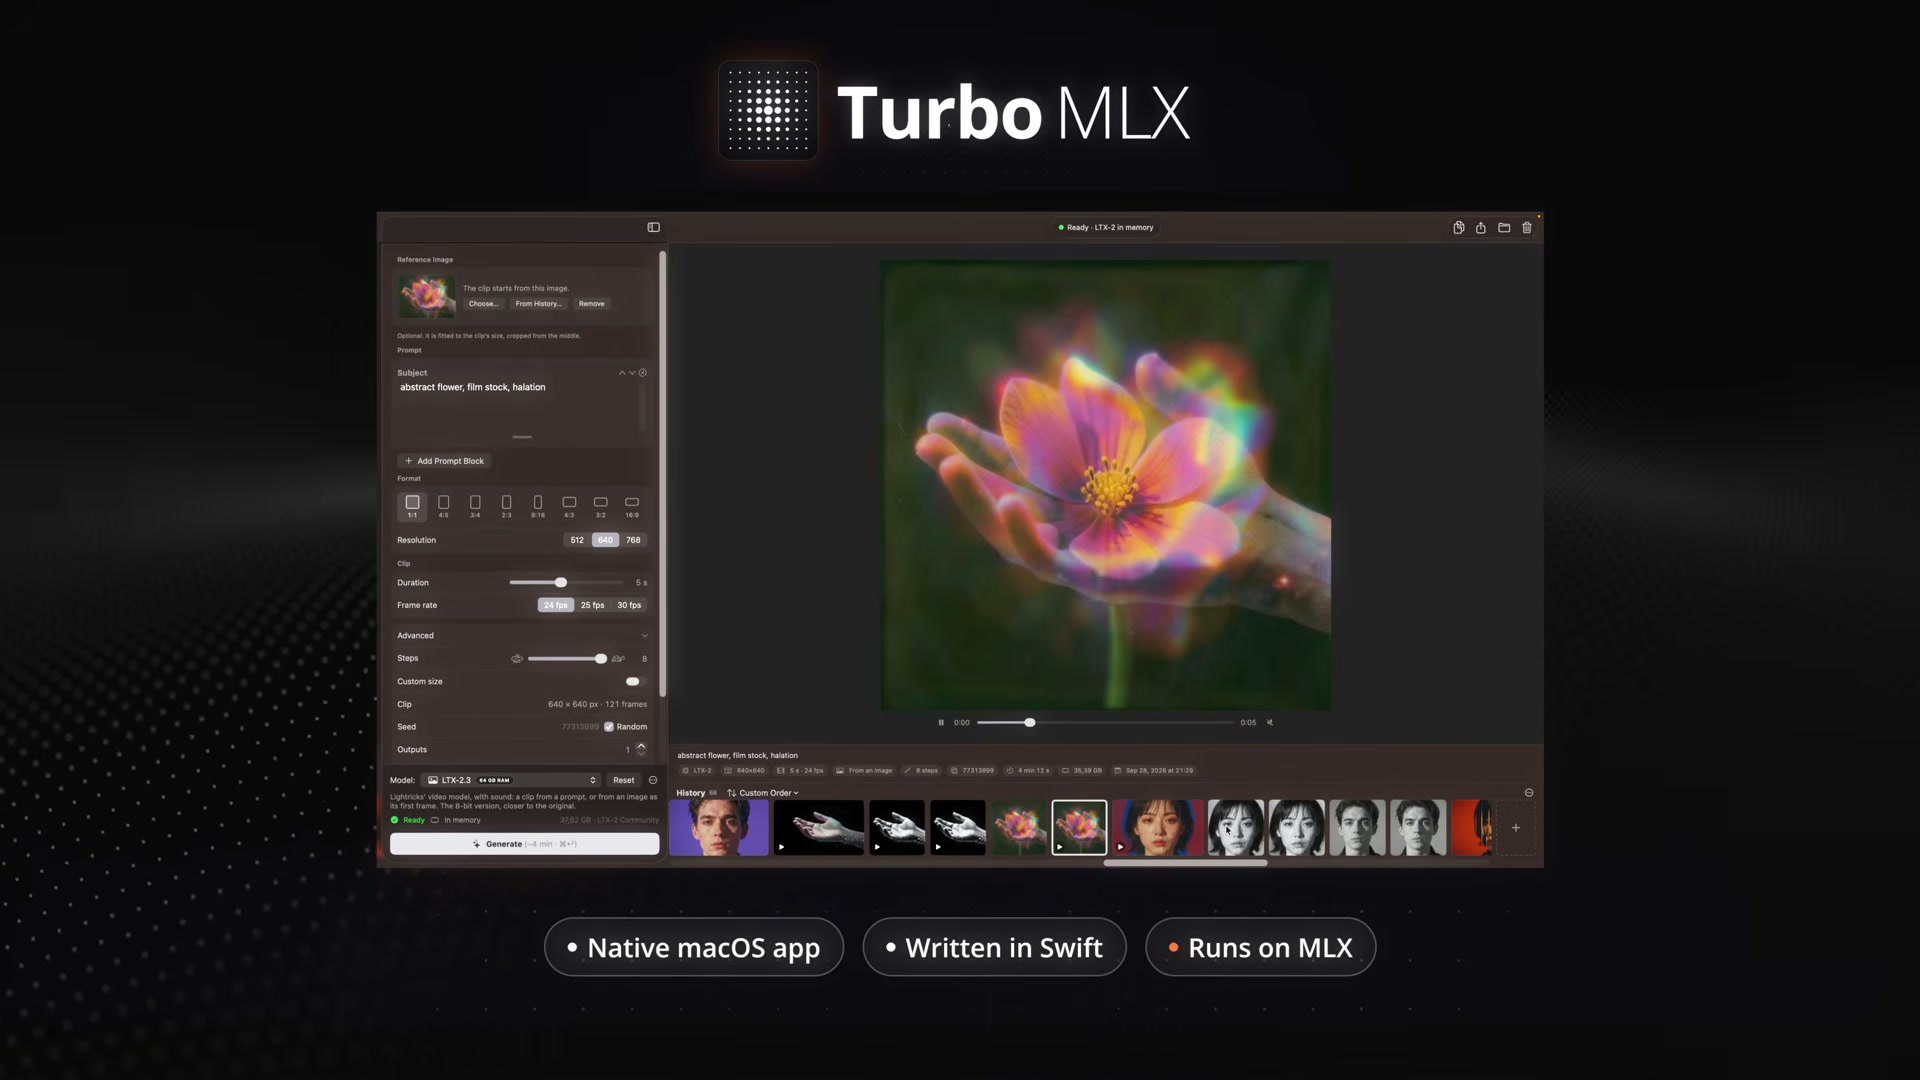
ภาพจากคลิป (00:22): Turbo MLX — Native macOS app • Written in Swift • Runs on MLX
2. ทำไม Native Swift + MLX ถึงเร็วกว่าเครื่องมือ Python + PyTorch แบบเดิม?
เครื่องมือรัน Local AI ส่วนใหญ่ (เช่น WebUI หรือ ComfyUI ที่รันผ่าน Python) ยอดเยี่ยมมากสำหรับการทดลองเชิงวิจัย แต่บน macOS มันต้องผ่านหลายชั้นตั้งแต่วงจร Python → PyTorch → Diffusers → Bindings → Metal API ก่อนจะถึง GPU ส่งผลให้มี Overhead ทั้งความเร็วและหน่วยความจำ
Turbo MLX ตัดคนกลางทั้งหมดออก เหลือแค่ Prompt ของคุณ → Swift → Apple MLX → GPU ส่งคำนวณตรงสู่ Metal GPU บนชิป M ทำให้ทุกวินาทีถูกใช้ไปกับการเจนภาพและวิดีโออย่างแท้จริง:
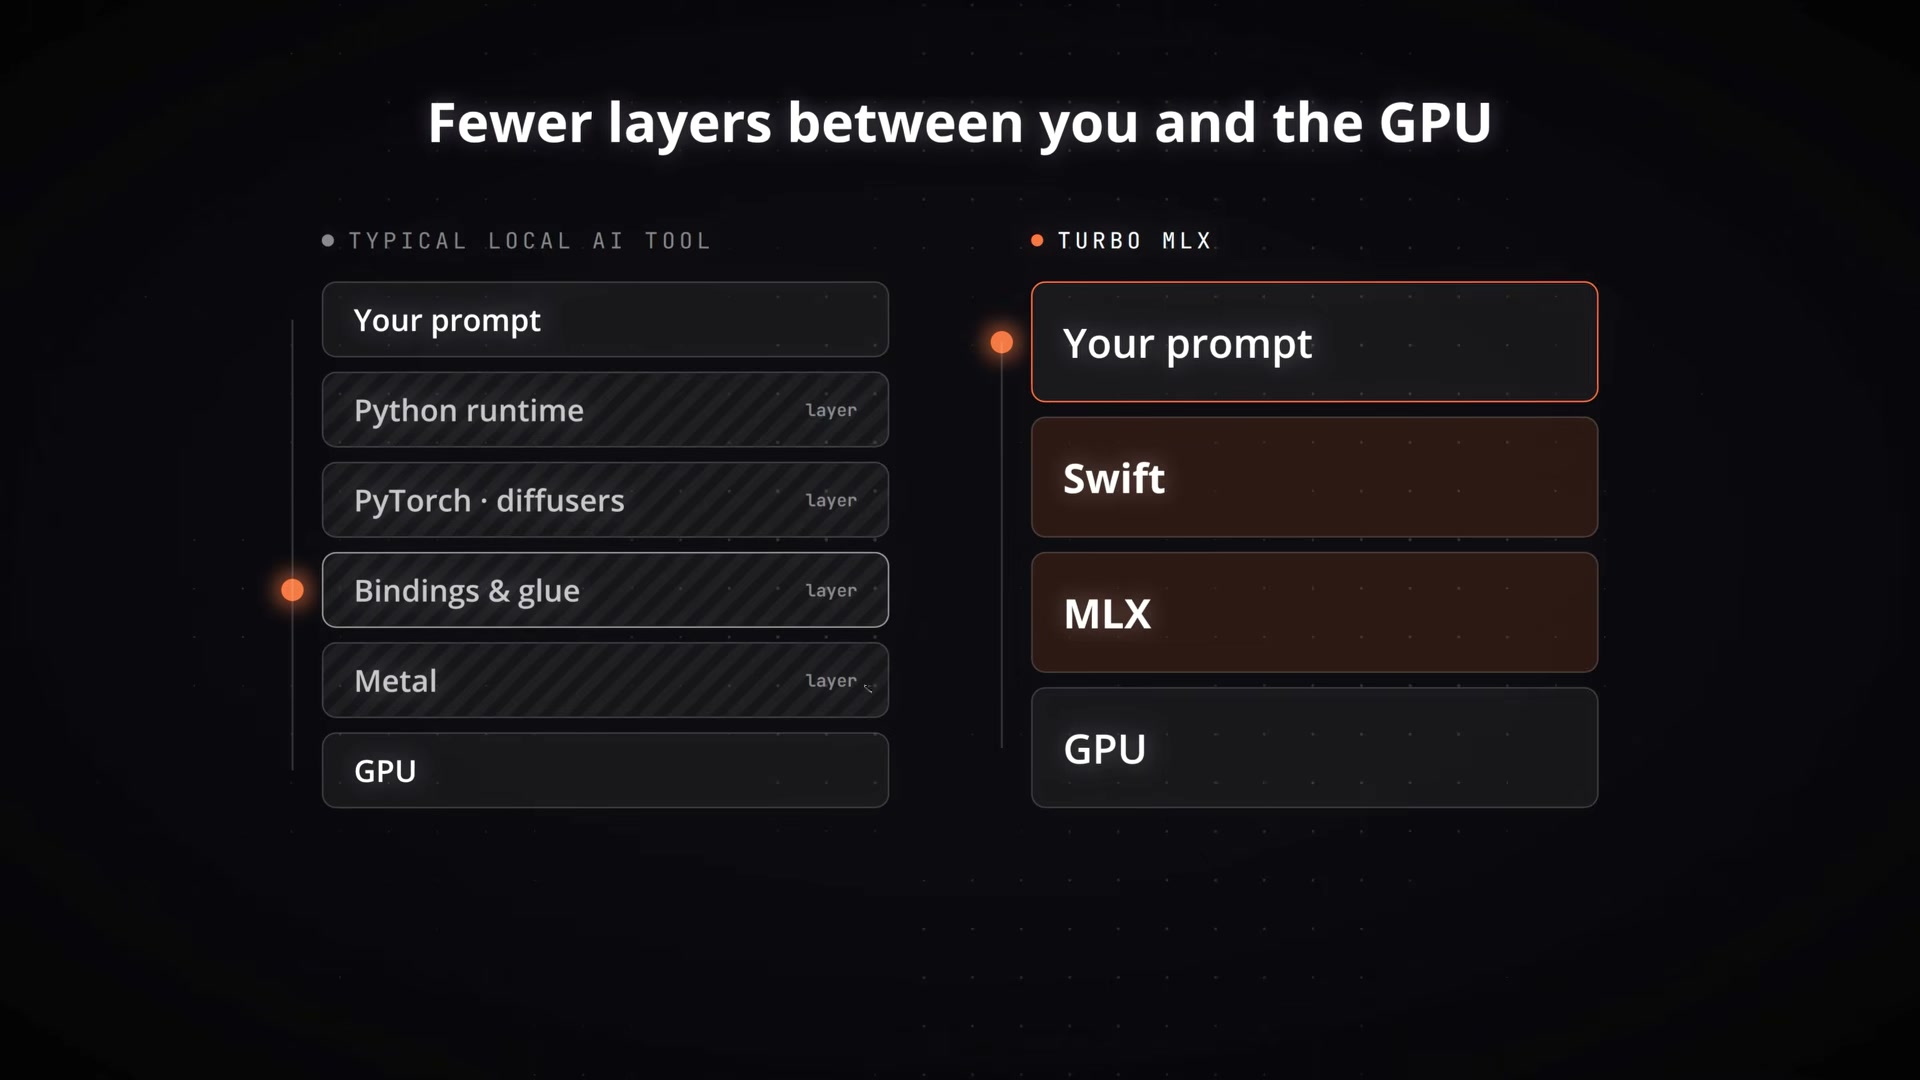
ภาพจากคลิป (00:36): Fewer layers between you and the GPU — ตัดชั้น Python/PyTorch ออก เหลือ Swift + MLX ตรงถึง GPU
3. ความลับของ Apple Silicon: Unified Memory & ต้นทุนต่อภาพ $0.00
การรันโมเดลระดับ 20B Parameters หรือโมเดลวิดีโอบน PC ปกติ ต้องซื้อการ์ดจอที่มี VRAM สูงๆ ราคาหลายหมื่นถึงหลักแสนบาท เพราะ CPU System RAM กับ GPU VRAM แยกจากกันและต้องคอยคัดลอกข้อมูลข้ามบัส PCIe แต่บน ชิป M1–M5 ของ Apple ใช้สถาปัตยกรรม Unified Memory ที่ CPU และ GPU ใช้หน่วยความจำก้อนเดียวกัน:
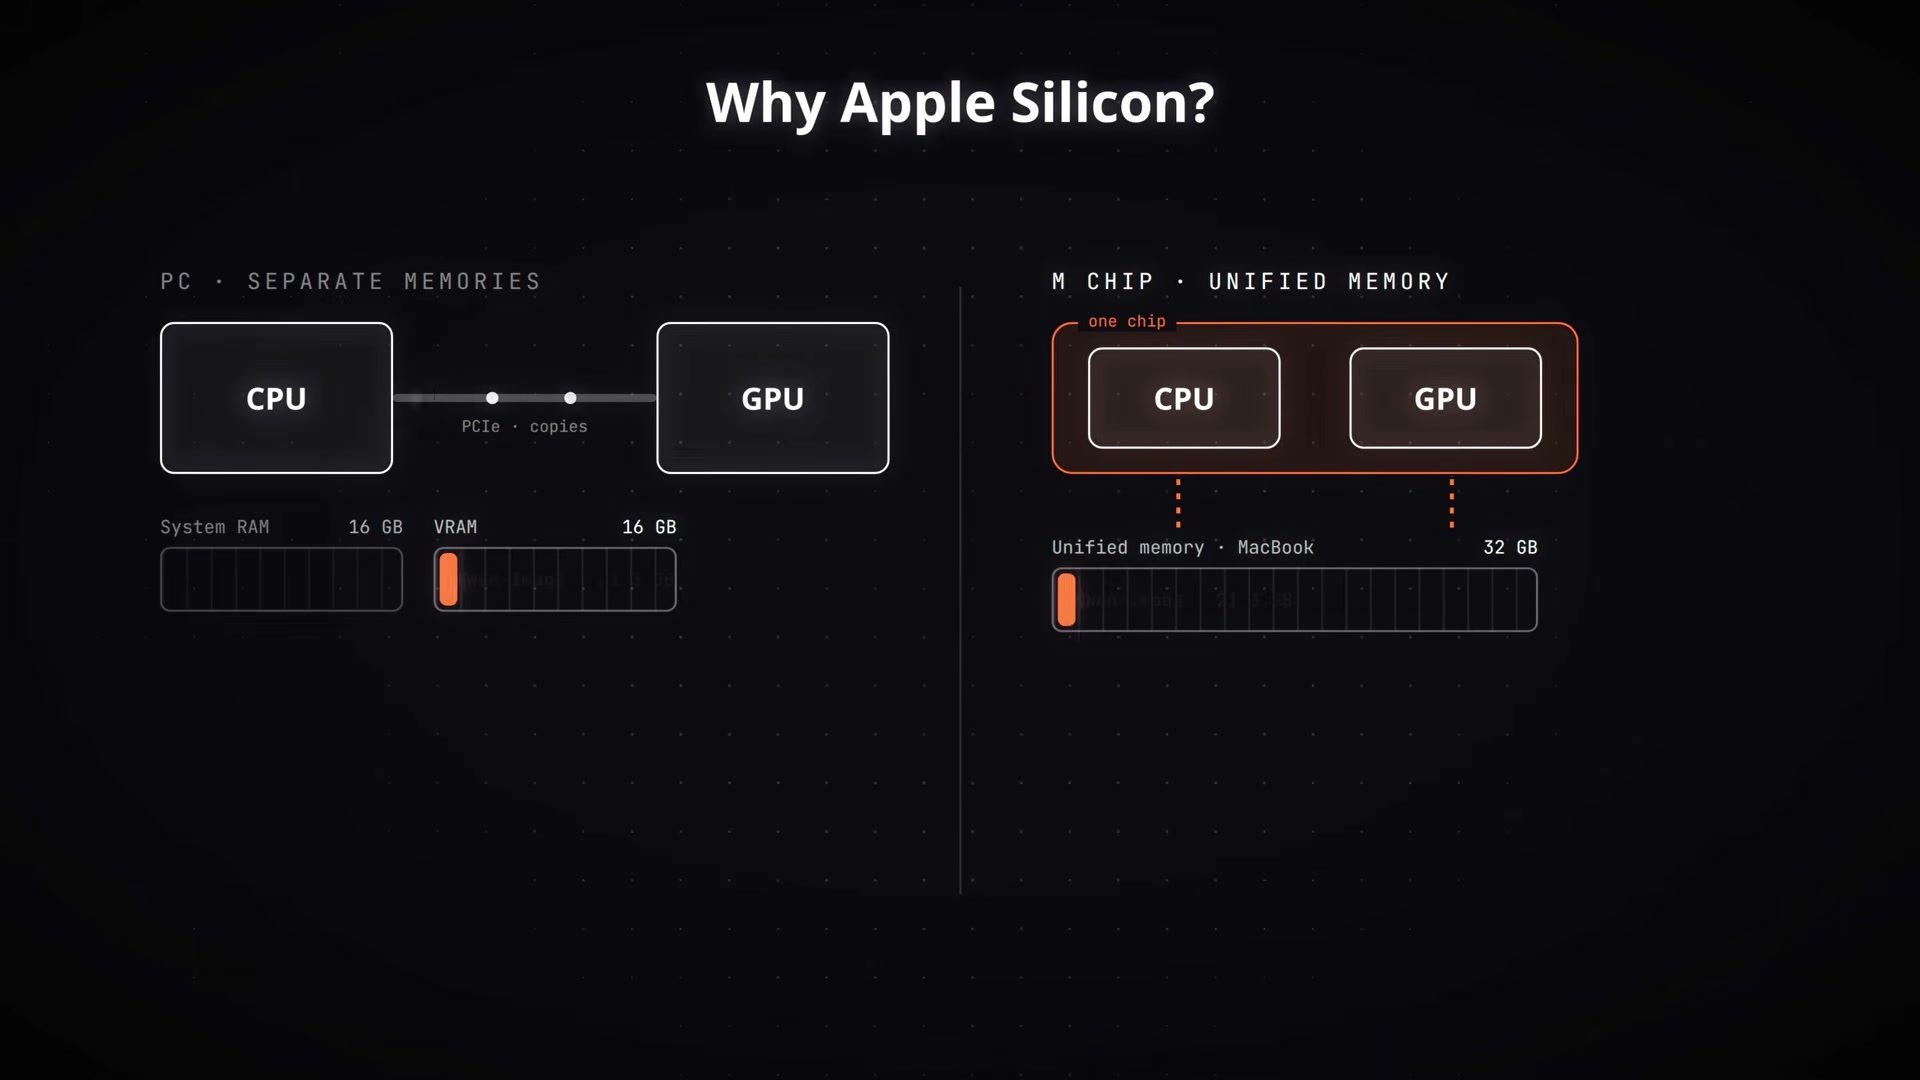
ภาพจากคลิป (01:02): ชิป M ใช้ Unified Memory ร่วมกัน ทำให้ MacBook แรม 32 GB สามารถโหลดโมเดลขนาดใหญ่ที่ปกติต้องพึ่งการ์ดจอราคาแพงได้
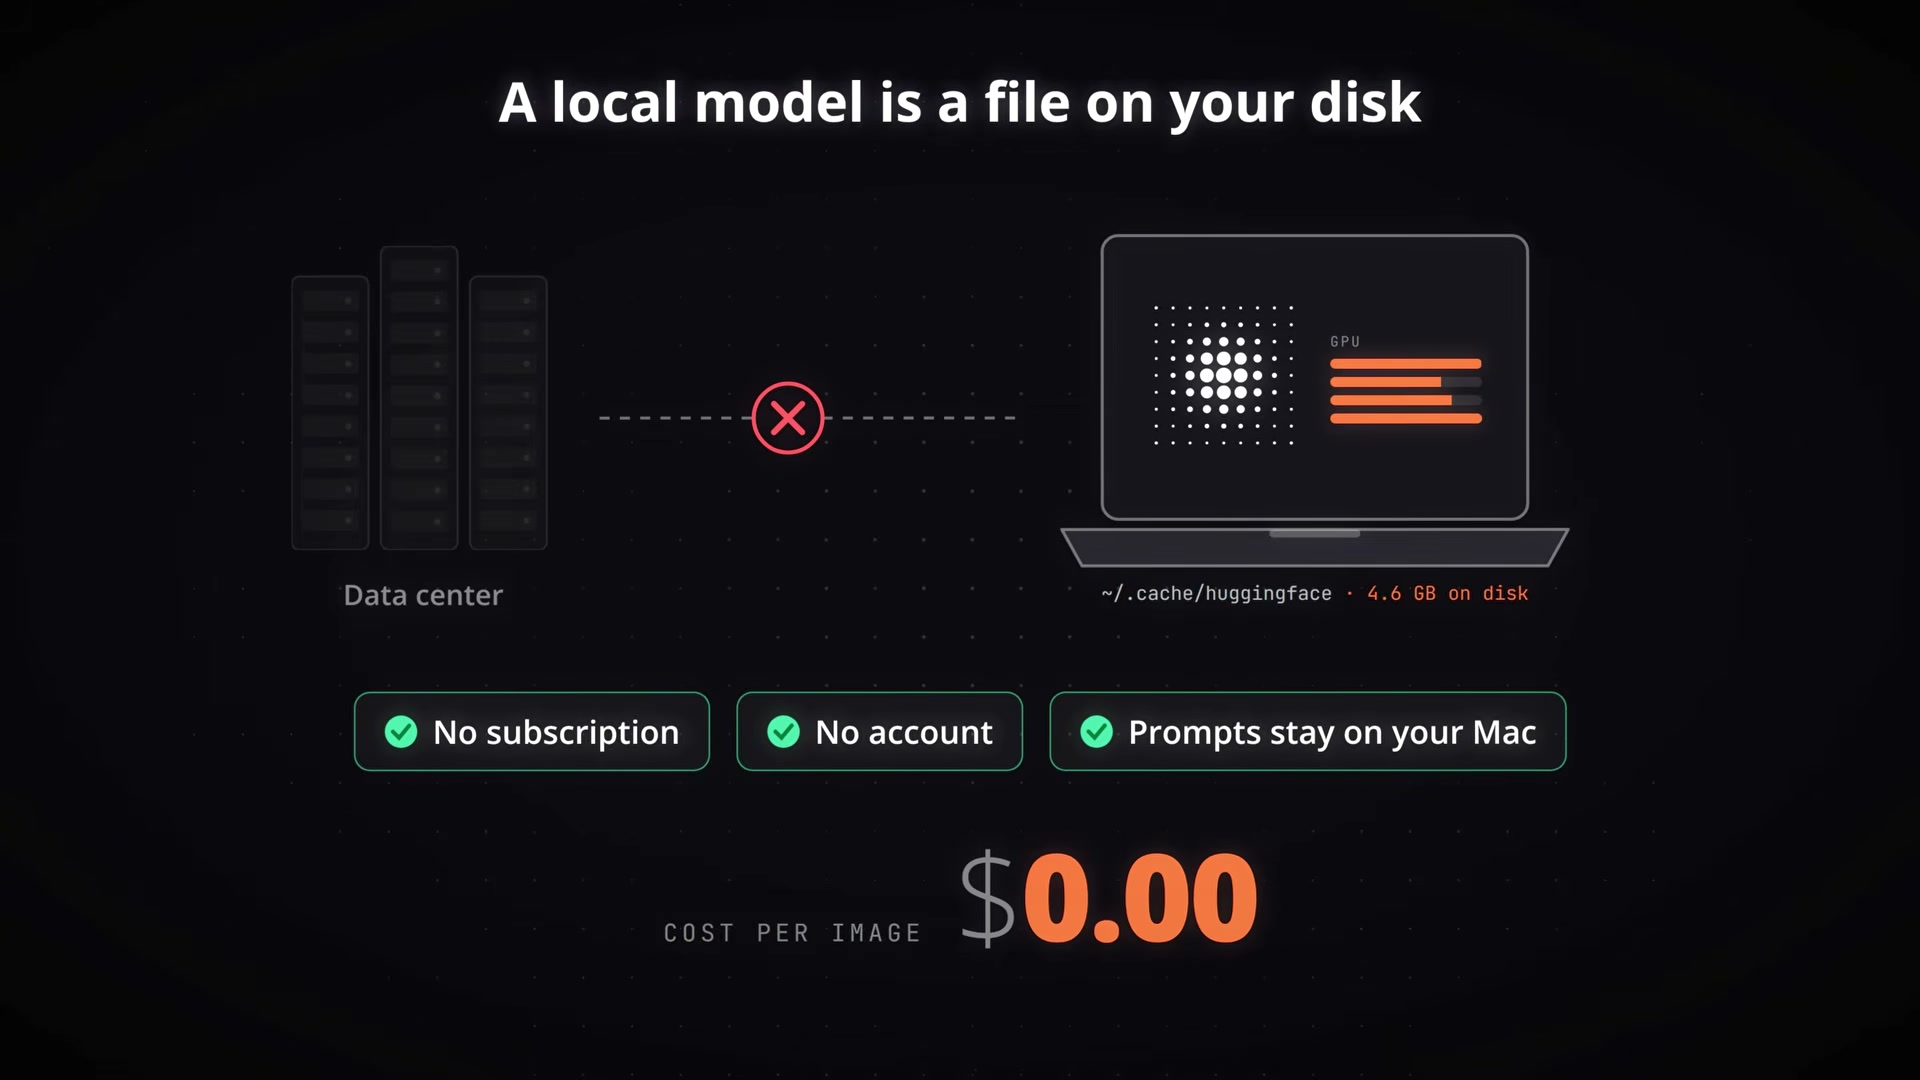
ภาพจากคลิป (00:54): โมเดลถูกเก็บเป็นไฟล์ในเครื่อง (~/.cache/huggingface) ไม่มีบัญชี ไม่มีค่ารายเดือน Prompt และภาพไม่เคยถูกส่งขึ้นคลาวด์ (Cost per image = $0.00)
4. เจาะลึกหน้าตาแอปและฟีเจอร์ใช้งานจริงใน Turbo MLX (UI Walkthrough)
หน้าจอของ Turbo MLX ออกแบบสไตล์ macOS แท้ แบ่งซ้าย-ขวา-ล่างอย่างชัดเจน กดใช้งานง่ายมากแม้ไม่เคยแตะ ComfyUI มาก่อน:
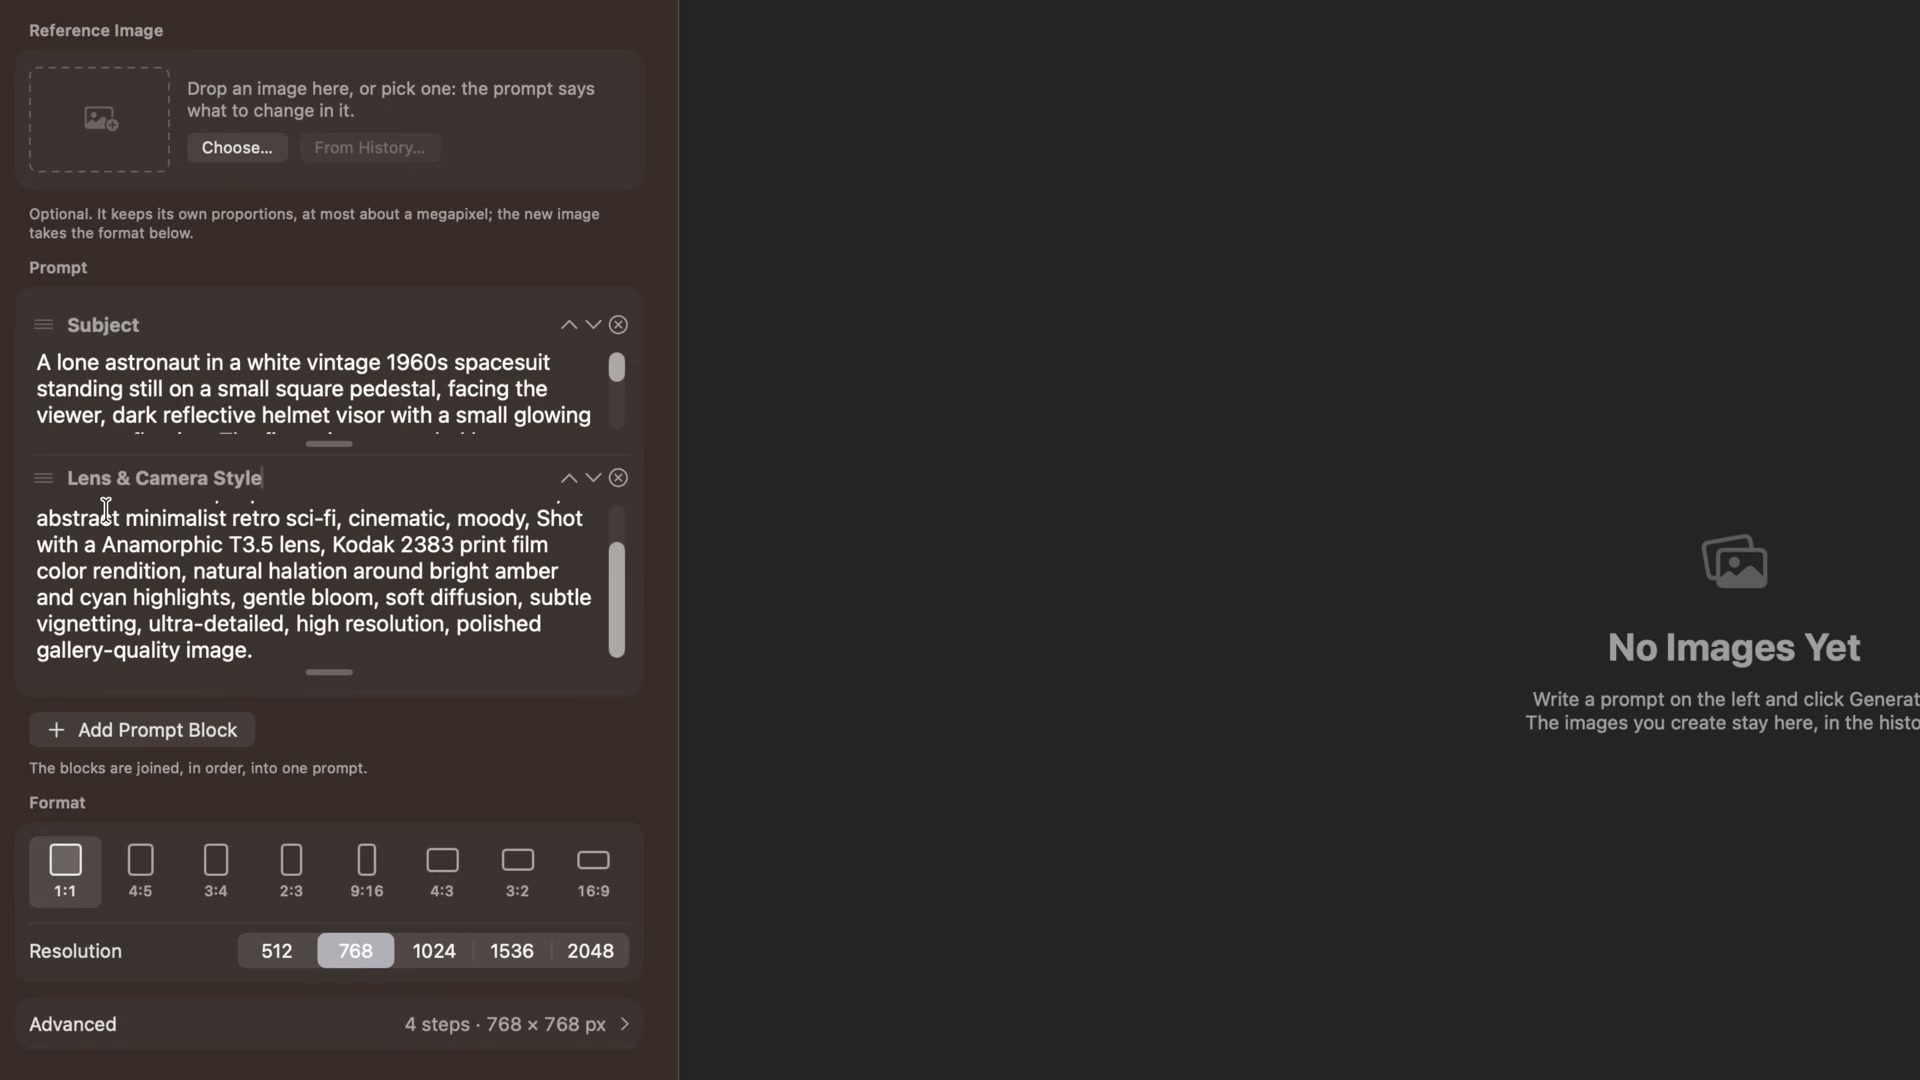
ภาพจากคลิป (01:20): แผงฝั่งซ้ายประกอบด้วย Reference Image, Prompt Blocks (แยก Subject / Style ลากสลับลำดับได้), Ratio และ Resolution
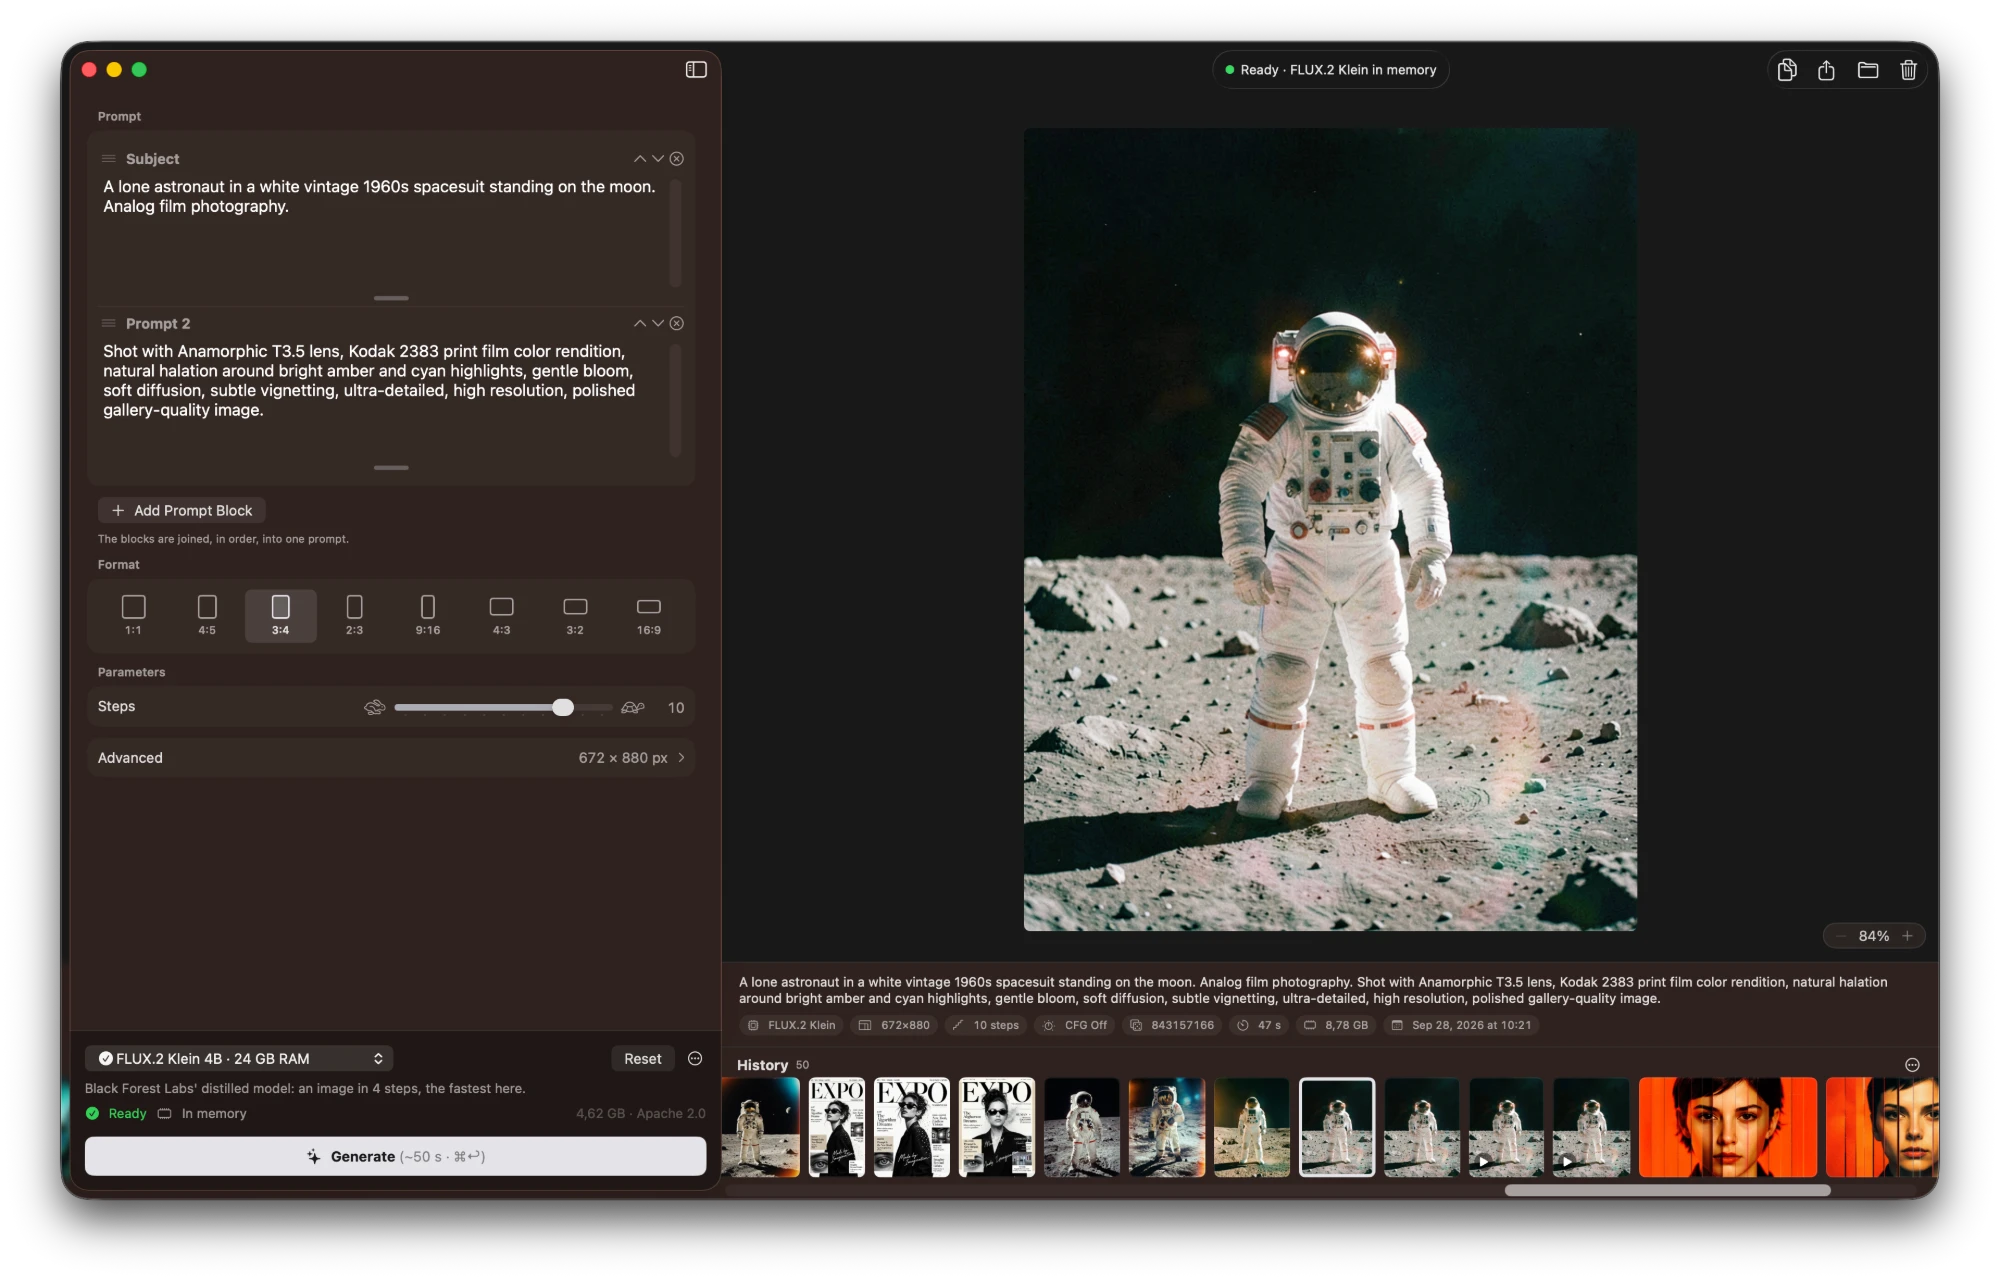
หน้าจอเต็มทางการจาก rinste/turbo-mlx: ด้านขวาแสดงภาพ/วิดีโอ, Live Preview ระหว่างเรนเดอร์, ปุ่ม Zoom และแถบ History ที่คลิกดึง Prompt + Seed เก่ากลับมาต่อยอดได้
- Prompt Blocks แบบโมดูลาร์: พิมพ์ Prompt แยกเป็นก้อน Subject, Lens & Camera Style หรือกด
+ Add Prompt Blockตั้งชื่อ ย่อ-ขยาย หรือลากสลับลำดับได้อย่างอิสระ (และรองรับ Negative Prompt สำหรับโมเดลที่รองรับ) - Reference Image & First/Last Frame Video: ลากภาพจาก Finder หรือจาก History มาวางเพื่อให้ AI แต่งภาพตามคำสั่ง หรือใช้เป็นเฟรมเริ่มต้นและเฟรมสุดท้ายในการเจนวิดีโอ LTX
- Generate Timing Estimate (ไม่มีเครดิต!): ปุ่ม
Generate (⌘↩)จะประเมินเวลาจริงตามเครื่องของคุณจากประวัติครั้งก่อน (เช่น~50 sหรือ~4 min) - รองรับไฟล์ LoRA (
.safetensors): ใส่ LoRA เฉพาะทางสำหรับ Z-Image, FLUX.2/3 Klein, Qwen-Image และ LTX-2.3/2.5 พร้อมสไลเดอร์ปรับน้ำหนักและคลิกเติม Trigger Word อัตโนมัติ - แถบ History อัจฉริยะ: กดปุ่ม
← →หรือคลิกภาพเก่าใน History เพื่อนำ Prompt, Model และ Settings เดิมกลับมาแก้และเรนเดอร์ Seed ใหม่ได้ทันที
5. รวมลิสต์โมเดลทั้งหมดที่รันได้ใน Turbo MLX (อัปเดต v1.11 + ลิงก์ Hugging Face)
ในวิดีโอ (ทดสอบบน MacBook M1 Max ชิปรุ่น M2/M3/M4/M5 จะยิ่งเร็วขึ้น) และในซอร์สโค้ดรุ่นล่าสุด v1.11 รองรับโมเดลครบทั้งสายภาพ, แก้ภาพ, ขยายภาพ 4K, วิดีโอพร้อมเสียง, เพลงร้อง, เอฟเฟกต์เสียง และโมเดล 3D:
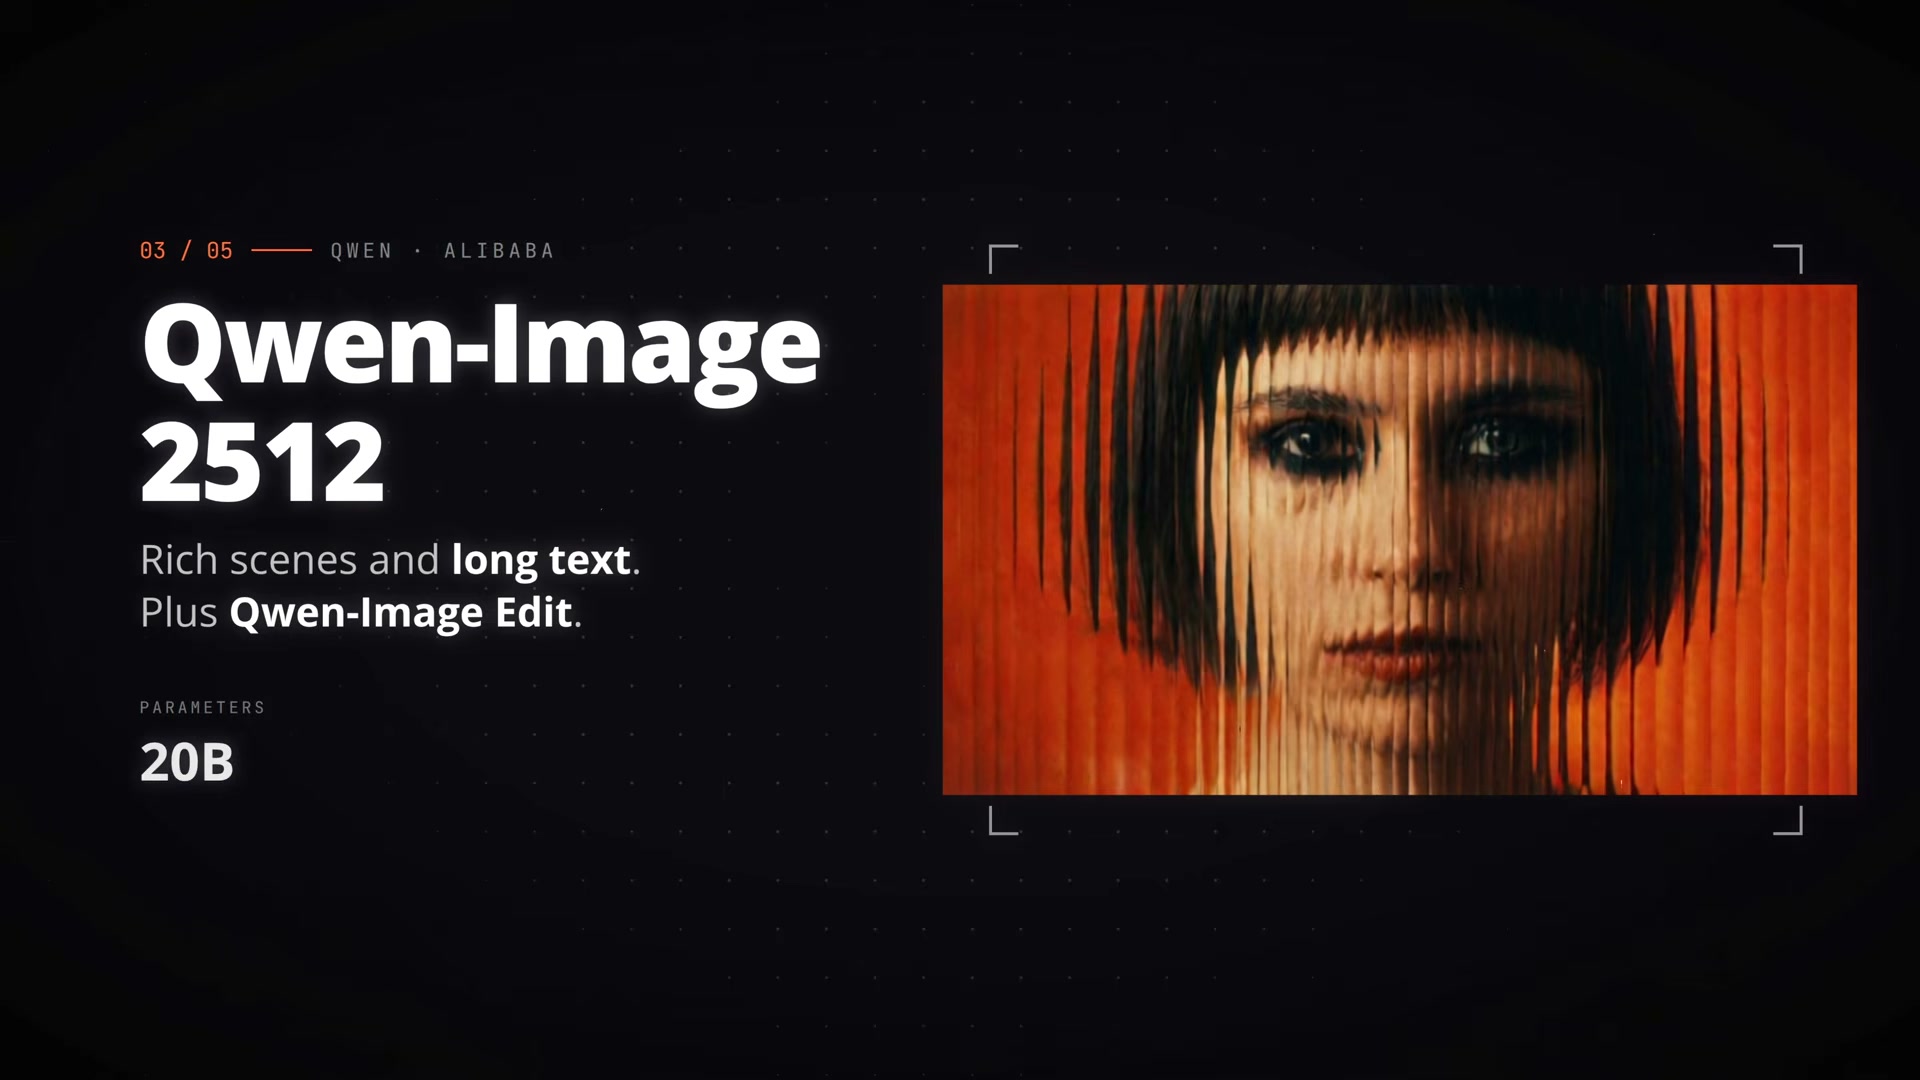
ภาพจากคลิป (01:55): Qwen-Image 2512 (20B) โมเดลเด่นด้านฉากซับซ้อนและการพิมพ์ข้อความยาวลงบนภาพ (ต้องการ Mac RAM 32 GB+)
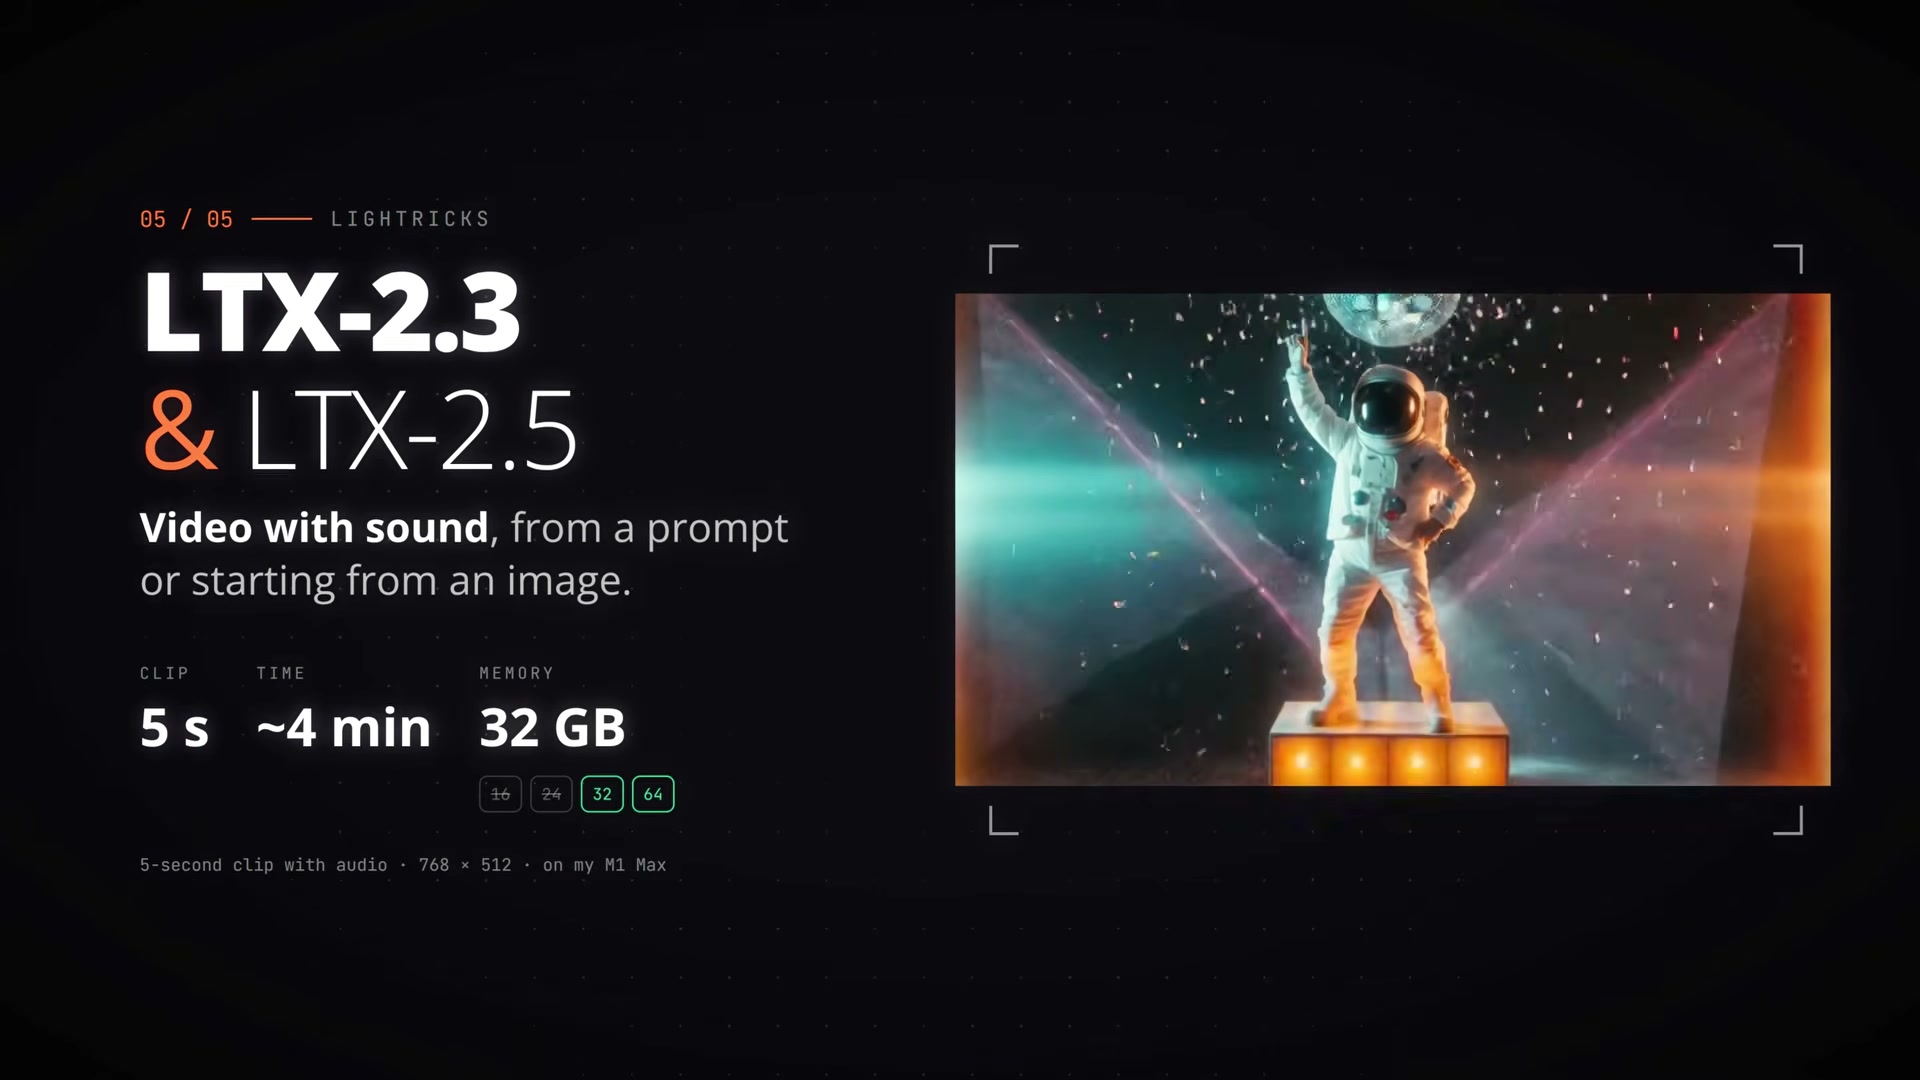
ภาพจากคลิป (02:11): LTX-2.3 & LTX-2.5 เจนวิดีโอ 5 วินาทีพร้อมเสียงในตัว ใช้เวลา ~4 นาทีบน M1 Max (แนะนำ RAM 32 GB)
| ชื่อโมเดล (คลิกดู Repo) | RAM ขั้นต่ำ | ขนาดไฟล์ | จุดเด่น & ความเร็ว (M1 Max / Spec) |
|---|---|---|---|
| FLUX.2 Klein 4B (4-bit) | 24 GB | 4.6 GB | เร็วที่สุด! 4 steps ใช้เวลาเพียง ~30 วิ/ภาพ พร้อมโหมดแก้ไขภาพตาม Prompt (Apache 2.0) |
| Z-Image Turbo (4-bit / 8-bit) | 16 GB / 24 GB | 5.9 GB / 11 GB | ภาพถ่ายสมจริงและพิมพ์ตัวอักษรในภาพคม (9 steps) รันได้บน Mac 16 GB ตัวเริ่มต้น (Apache 2.0) |
| FLUX 3 Image Klein | 16 GB | 20.3 GB | รุ่นใหม่ล่าสุดจาก Black Forest Labs (5.6B, 16 steps) ภาพ+ตัวอักษรสวยและแก้ภาพได้ |
| SenseNova-U1.5 & Ming-Image | 16 GB / 24 GB | 11.8 GB / 19.3 GB | สายกราฟิกดีไซน์, โปสเตอร์, อินโฟกราฟิก และส่งออก PNG พื้นหลังโปร่งใส (Transparent) |
| Qwen-Image 2512 & Edit 2511 | 32 GB | 27.6 / 29 GB | ขนาด 20B Parameters ฉากซับซ้อน ตัวอักษรยาว และแก้ภาพแบบรักษาพื้นหลังเดิมแม่นยำ |
| LTX-2.5 & LTX-2.3 Video | 32 GB (64 GB 8-bit) | 28.5–37.8 GB | สร้าง วิดีโอพร้อมเสียง จาก Prompt หรือ First/Last Frame (คลิป 5 วิ ~4 นาทีบน M1 Max) |
| SeedVR2 Upscaler 3B | 16 GB | 7.3 GB | ขยายภาพคมชัด 2–4 เท่า สูงสุด 4096 × 4096 ไม่ต้องพิมพ์ Prompt |
| MiniMax-Music3 & MOSS-SoundEffect | 16 GB | 9.2 GB / 8.4 GB | สร้างเพลงร้องความยาวสูงสุด 6 นาที (WAV 44.1 kHz) + เอฟเฟกต์เสียง 0.5–30 วิ (v1.11) |
| Idol 3D (8-bit) | 16 GB | 3.0 GB | แปลงภาพวัตถุ 1 ภาพให้เป็นไฟล์ 3D (.glb) รอบด้าน 360 องศา |
6. Local Models vs Cloud Models: เลือกใช้แบบไหนดี (+ รู้จัก Node Composer)
ผู้สร้างคลิปพูดไว้อย่างตรงไปตรงมาว่า โมเดล Local ส่วนใหญ่ยังเทียบคุณภาพสูงสุดกับ Frontier Cloud Models อย่าง Nano Banana หรือ GPT Image ไม่ได้เต็ม 100% แต่ Turbo MLX ยอดเยี่ยมมาก สำหรับการทดลอง Prompt, ลองปรับแต่ง Setting, เจนงานศิลปะส่วนตัว และงานที่ต้องการความเป็นส่วนตัวสูงสุดโดยไม่เสียค่าเครดิต
ส่วนถ้าคุณต้องการผลิตงานระดับ Commercial Pipeline ที่รวมโมเดลคลาวด์รุ่นล่าสุดเข้าไว้บน Canvas เดียว (เช่น Kling V3/O3, ChatGPT Image, Qwen Image Pro, Avatars) โดยจ่ายตามจริงไม่บวก Markup และบันทึกไฟล์ลงเครื่องอัตโนมัติ ผู้สร้างได้แนะนำแพลตฟอร์มคู่ขนานชื่อ Node Composer (node-composer.studio) ไว้ด้วยครับ:
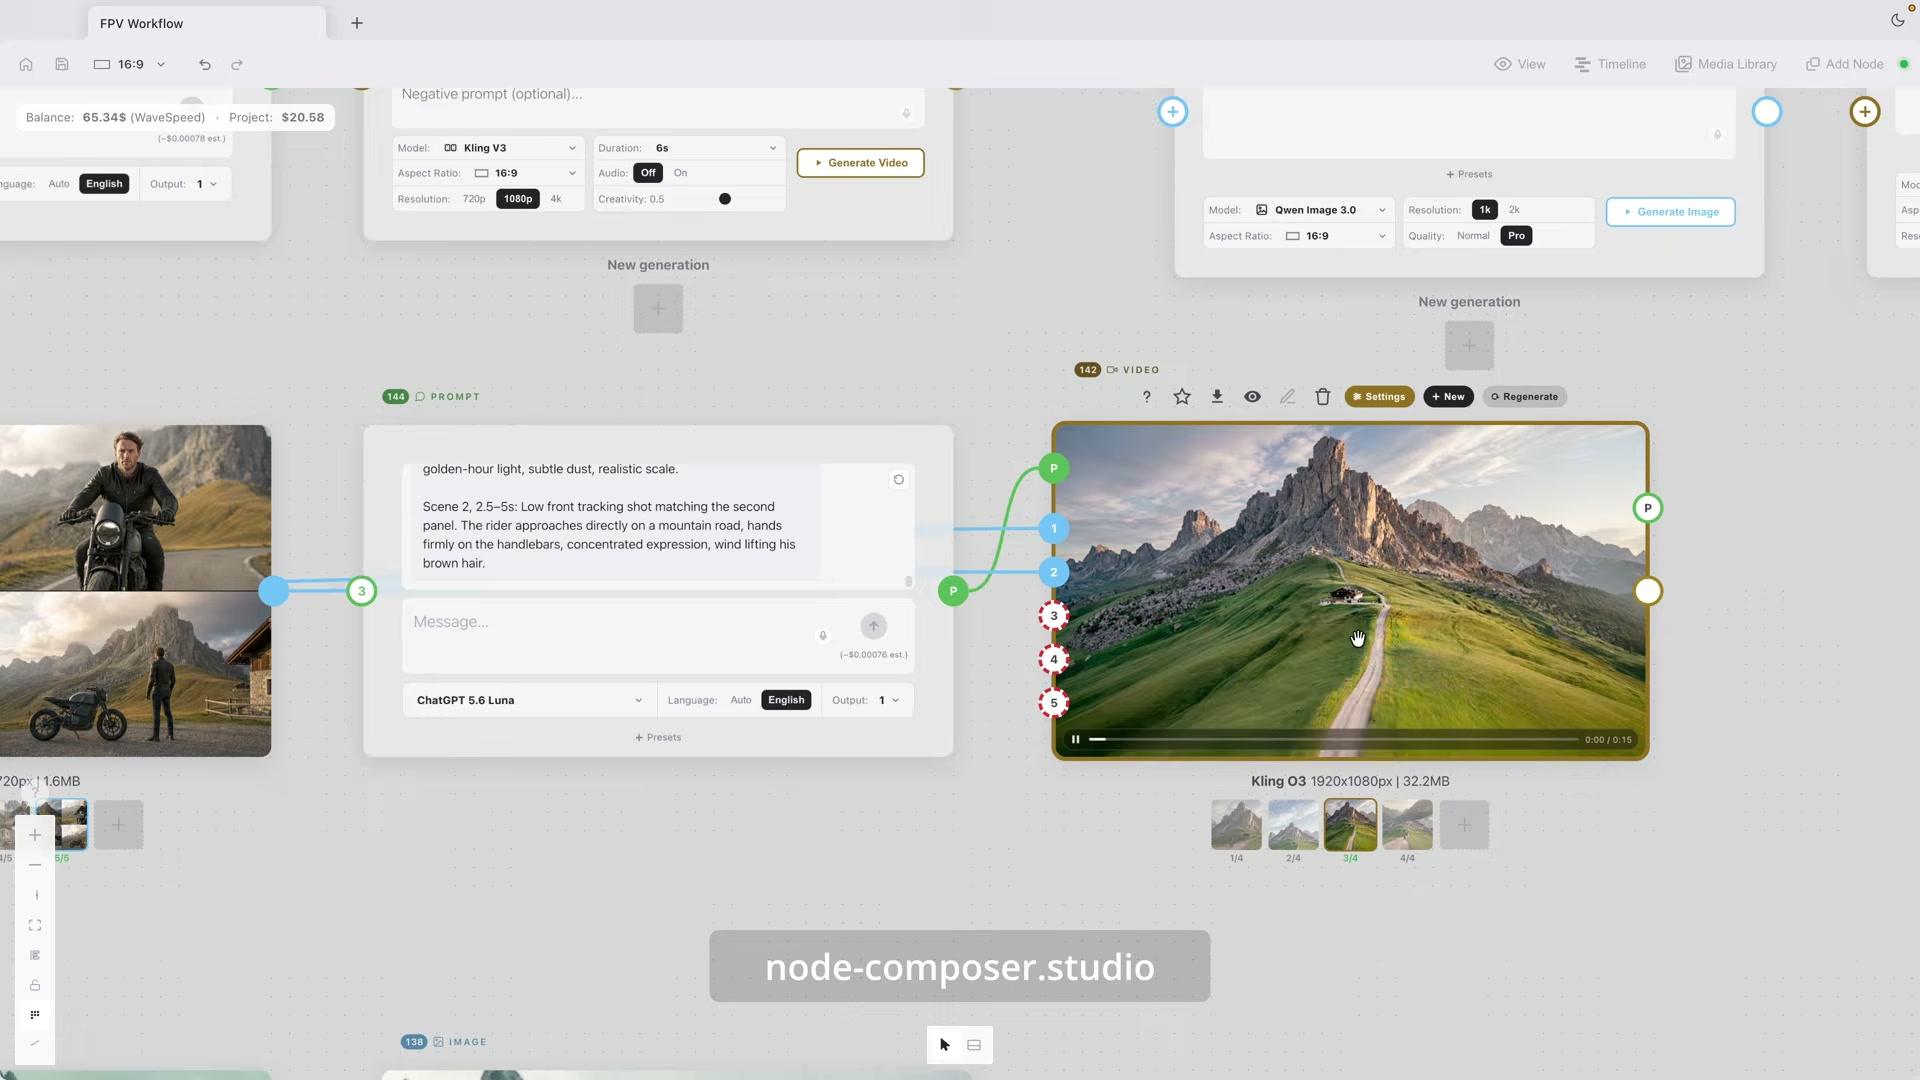
ภาพจากคลิป (02:50): Node Composer (node-composer.studio) สาย Cloud Canvas สำหรับงานโปรดักชันเต็มรูปแบบที่เชื่อม Prompt, ภาพอ้างอิง และวิดีโอเข้าด้วยกัน
7. วิธีติดตั้งและเริ่มต้นใช้งาน Turbo MLX ใน 3 นาที
- ตรวจสอบสเปก Mac: ต้องเป็น Mac ที่ใช้ชิป Apple Silicon (M1 / M2 / M3 / M4 / M5), ระบบปฏิบัติการ macOS 15 ขึ้นไป, แนะนำ RAM 16 GB ขึ้นไป (32 GB+ สำหรับ Qwen-Image 2512 และ LTX-2.5) และพื้นที่ว่าง SSD 10–40 GB
- ดาวน์โหลดและติดตั้ง: โหลดไฟล์ล่าสุด
Turbo-MLX-1.11.dmgจาก GitHub Releases เปิดไฟล์แล้วลากแอปเข้าโฟลเดอร์Applications(ไม่ต้องลง Homebrew หรือ Python และแอปอัปเดตตัวเองอัตโนมัติผ่าน Sparkle appcast) - เลือกโมเดลเริ่มต้นที่มุมซ้ายล่าง:
- เครื่อง RAM 16 GB: แนะนำเริ่มที่ Z-Image Turbo (4-bit) (5.9 GB) หรือ SenseNova-U1.5 (11.8 GB)
- เครื่อง RAM 24–32 GB+: ลอง FLUX.2 Klein 4B (เร็ว ~30 วิ/ภาพ) หรือ LTX-2.5 สำหรับวิดีโอพร้อมเสียง
- กด Download and Generate (⌘↩): รอโหลดโมเดลครั้งเดียว (หยุดแล้วโหลดต่อได้) จากนั้นพิมพ์ Prompt แยกบล็อก Subject + Style แล้วสร้างผลงานได้แบบออฟไลน์ตลอดไป
เลือกใช้งานคลัง Prompt ภาพถ่าย 2,381+ แบบ (Image Builder), สตูดิโอวิดีโอ & การ์ตูน 200 สไตล์ หรือโหลด Turbo MLX ไปรันฟรีบน Mac ของคุณ