นักพัฒนาจำนวนมากยังคงเรียกใช้โมเดลภาษา (Chat LLM) เพื่อทำงานแค่ “เลือกหมวดหมู่ คัดกรองสแปม ให้คะแนนความเสี่ยง หรือตอบ ใช่/ไม่ใช่” ทั้งที่ต้องเสียเวลาพ่น Token ยาว แพง ช้า และยังได้ค่า Confidence ที่โมเดลคิดขึ้นมาเองแบบไม่ได้ผ่านการ Calibrate — Jev (jev-1.13.0) จาก TypeSafe AI จึงถูกสร้างมาเป็น System One Model โดยเฉพาะ: ไม่สร้างข้อความ (Never Generates Text) แต่รับ state + คำถามที่มีชนิดข้อมูลชัดเจน (Choice, Score, Noul) แล้วคืนคำตัดสินแบบ Type-Safe พร้อมความน่าจะเป็นที่ผ่านการ Calibrate จริงใน ~100–200 ms ในบทความนี้เราสรุปวิธีออกแบบระบบให้ถูกต้อง พร้อมแจกฟรีชุดสกิล building-with-typesafe-jev (github.com/aaddrick/building-with-typesafe-jev, MIT License) ที่ทำคะแนนทดสอบสูงถึง 0.96 ชนะทั้งกรณีไม่ใช้สกิล (0.65) และ Official Skill (0.77) ครับ
รวมครบทั้ง SKILL.md, api-reference.md, patterns.md และ 11 รูปแบบสถาปัตยกรรม Prior Art (150+ โปรเจกต์จริง) พร้อมใช้งานใน 1 คลิก
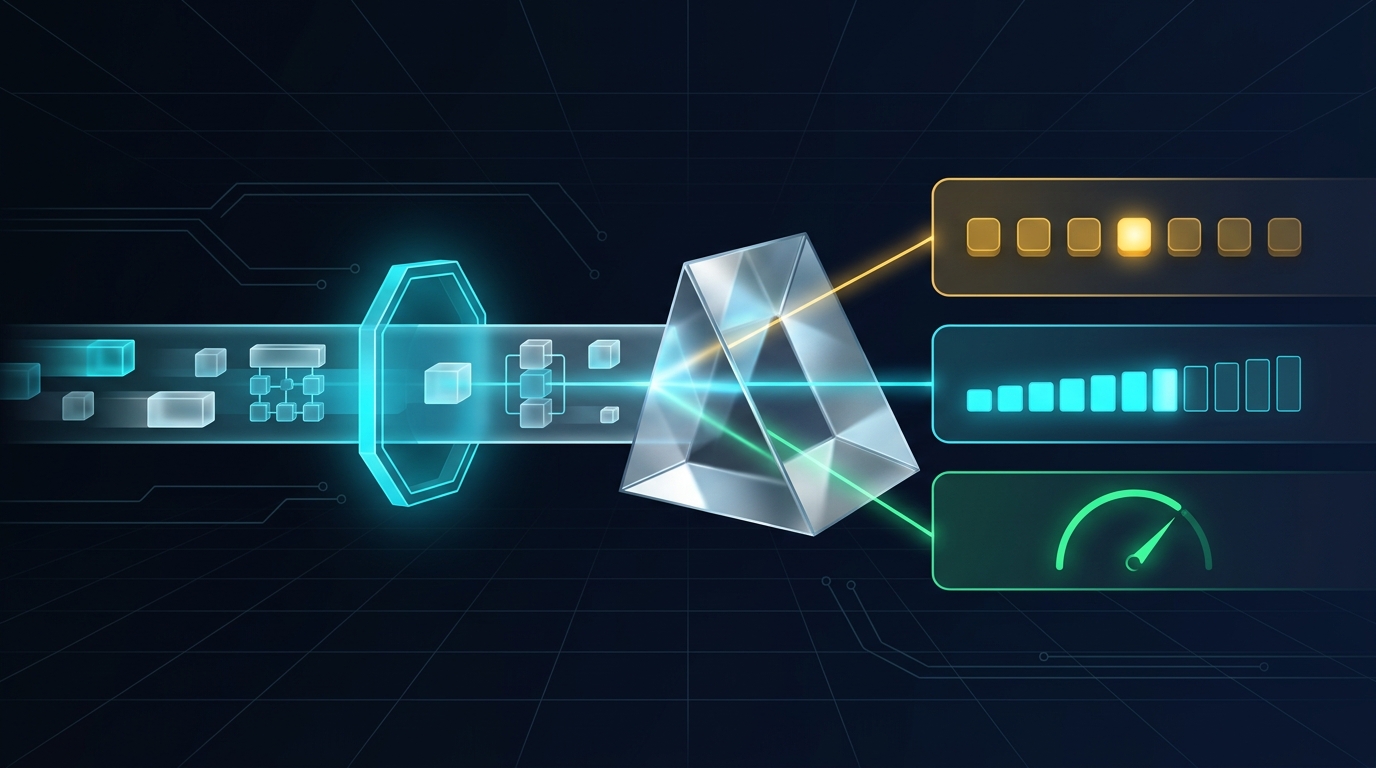
TypeSafe Jev (System One) ทำงานร่วมกับโค้ดแบบ Deterministic Backstop: โค้ดเป็นคนคุม Flow ส่วน Jev ส่งคำตัดสินแบบ Typed Decisions พร้อมความน่าจะเป็น
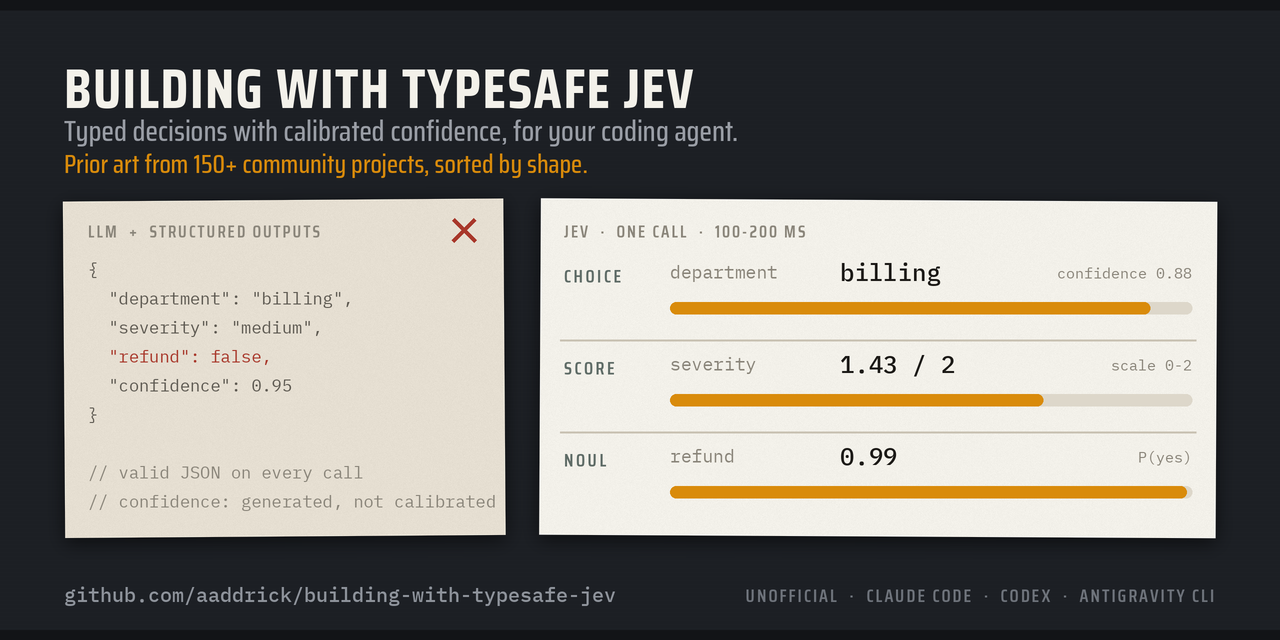
ภาพเปรียบเทียบจากผู้สร้างสกิล: Chat LLM Structured Output แค่ได้ JSON ที่ถูกต้อง แต่ตัวเลข confidence มาจากการเจนคำ ไม่ได้ผ่านการ Calibrate ต่างจาก Jev ที่ตอบ Choice, Score และ Noul พร้อมความน่าจะเป็นจริงใน 1 Call (100–200 ms)
1. TypeSafe Jev (System One) คืออะไร? ต่างจาก Chat LLM อย่างไร?
ในทางจิตวิทยาการรู้คิด System One คือการตัดสินใจฉับพลันตามสัญชาตญาณ (1–2 วินาที) ส่วน System Two คือการคิดวิเคราะห์เชิงเหตุผลทีละขั้น — โมเดล Jev (jev-1.13.0) ของ TypeSafe AI ออกแบบมาเป็น System One ผ่าน Endpoint POST https://api.typesafe.ai/v1/systemone โดยยึดกฎหลักว่า:
“Code owns the workflow. Jev supplies narrow snap judgments.” — โค้ดของคุณเป็นเจ้าของลำดับการทำงานและการบังคับใช้นโยบาย ส่วน Jev ทำหน้าที่ให้คำตัดสินย่อยแบบมีชนิดข้อมูลเท่านั้น
- ความเร็วระดับ 100–200 ms: เหมาะกับ Gate, Control Loop, Live UI, Browser Agent และ Stream Filtering ที่รอ Chat LLM 2–5 วินาทีไม่ไหว
- ราคา $0.042 / 1 ล้าน Input Tokens (Output Tokens ฟรี!): เพราะ Jev ไม่พ่นข้อความคำตอบยาวๆ ต้นทุนจึงต่ำมาก เช่น คัดกรองโพสต์บนโซเชียลตก ~$0.00003/โพสต์ หรือกรอง Log 1 ล้านบรรทัดในราคา ~$10
- Context Window 64k Tokens (สูงสุด 32k ต่อ 1 คำถามเดี่ยว): ส่งได้ทั้ง String, JSON Object และ Array พร้อม Rate Limit
250,000 tokens/s(1,200 req/min) และ Zero Data Retention (ไม่ใช้ Request ลูกค้าไปเทรนโมเดล) - ขอบเขตสำคัญ: Jev เป็นโมเดล Text-only (ถนัดภาษาอังกฤษที่สุด ภาษาอื่นแม่นยำรองลงมา) ไม่รองรับ Fine-tuning หรือ LoRA — เราปรับพฤติกรรมได้ 100% ผ่านการออกแบบ
state,instructionsและcriteria
2. เจาะลึก 3 Primitives หลักของ Jev (Choice, Score, Noul) + สูตร Confidence
ทุกคำถามที่ส่งเข้าไปใน client.system_one(...) จะต้องเลือกใช้ 1 ใน 3 ชนิดข้อมูล (Primitives) เหล่านี้เพื่อให้คำตอบออกมาแบบ Type-Safe เสมอ:
| Primitive | เหมาะกับคำถามแบบไหน | ค่าที่ส่งกลับจาก API | การคำนวณ confidence & วิธี Branch ในโค้ด |
|---|---|---|---|
Choice |
เลือก 1 ตัวเลือกจากกลุ่มที่ไม่มีลำดับ (สูงสุด 255 ตัวเลือก ในรูป Map) + ควรมี other / none_of_the_above เสมอ |
choice, probabilities (รวมกันได้ 1.0), confidence |
confidence = (n · top - 1) / (n - 1) → เลือกด้วย choice และกั้น Threshold ด้วย confidence (แยกจากค่า probabilities[top]!) |
Score |
จัดอันดับบนสเกล 2–10 ระดับ ที่บรรยายเป็นสถานการณ์จริงแบบ 1 มิติ (ห้ามใช้คำคลุมเครือเช่น “ปานกลาง” หรือเลข “2”) | score (0 ถึง n-1 เป็นทศนิยมได้), legend, probabilities, confidence |
score = Σ i·pᵢ, confidence = 1 - Σ pᵢ|i - top|/U (กระจายไปช่องข้างเคียงหักน้อย กระจายข้ามฟากหักหนัก) → ใช้เทียบ Threshold หรือเรียงลำดับ |
Noul |
คำถาม ใช่ / ไม่ใช่ (แนบ criteria.true / criteria.false ได้) — ถ้ามีหลายป้ายที่เกิดพร้อมกันได้ให้แยกเป็นหลาย Noul |
noul = P(yes) ปัดเศษทศนิยม 2 ตำแหน่ง (ไม่มีฟิลด์ confidence) |
noul == 0.5 แปลว่า “ไม่แน่ใจ” ไม่ใช่ปานกลาง → Branch ด้วย noul > threshold และห้ามตั้งให้ true แปลความหมายในทางปฏิเสธ |
3. ทำไมต้องใช้สกิล building-with-typesafe-jev? (ผลทดสอบชนะ Official Skill 0.96 vs 0.77)
ผู้พัฒนาสกิล (aaddrick/building-with-typesafe-jev) พบว่าเวลาปล่อยให้ Coding Agent อย่าง Claude Code หรือ Codex เขียนโค้ด Jev เองโดยไม่มีสกิล Agent มักทำตัวเหมือนเขียนใส่ Chat LLM (ส่งทีละ 1 คำถาม, ขอให้ Jev นับเลข/บวกลบวันที่เอง, ลืมตัวเลือก other, หรือให้ Jev อนุมัติคำสั่งลบไฟล์ตรงๆ ไม่มีเกราะโค้ดกัน) — เมื่อนำมาทดสอบแบบ Controlled Container Evaluation 6 โจทย์ × 10 รอบ โดยใช้กรรมการ LLM 3 ค่าย (Claude Opus, GPT-6 Sol, Kimi K3) ผลออกมาชัดเจน:
| พฤติกรรมที่ตรวจในโค้ดของ Agent (เต็ม 10 รอบ) | No Skill | This Skill (แจกในบทความนี้) | Official Skill (typesafe-ai/skills) |
|---|---|---|---|
| คะแนนเฉลี่ยรวมทุกโจทย์ (Average Score) | 0.65 ± 0.05 | 0.96 ± 0.02 | 0.77 ± 0.04 |
| อ้างอิงชื่อฟิลด์ของ Input State ในคำถามตรงๆ | 0 / 10 | 10 / 10 | 1 / 10 |
Pin เวอร์ชันโมเดล (jev-1.13.0) หรือบันทึก response.model |
0 / 10 | 10 / 10 | 0 / 10 |
| มี Deterministic Code Backstop ดักคำสั่งอันตรายก่อนถึง Jev | 7 / 10 | 10 / 10 | 2 / 10 |
| ทำระบบนับจำนวน/วันที่ในโค้ดแทนการถาม Jev ตรงๆ | 1 / 10 | 8 / 10 | 0 / 10 |
| เดินต้นไม้ 1,200 หมวดด้วย Beam Search มากกว่า 1 เส้นทาง | 1 / 10 | 10 / 10 | 7 / 10 |
ภายในไฟล์ .zip (ดาวน์โหลดที่นี่) จัดวางแบบ Progressive Disclosure 16 ไฟล์ เพื่อไม่ให้เปลือง Context ของ Agent:
SKILL.md— เลือก Primitive, 11 กฎออกแบบ, วิธีคำนวณ & ใช้ตัวเลข, ตาราง Common Mistakes (โหลดทุกงาน Jev)api-reference.md— สเปก HTTP API, Python SDK (typesafe-sdk≥ 0.7.1), JS SDK (@typesafe-ai/sdk≥ 0.6.0), OpenRouter / Vercel AI Gatewaypatterns.md— 4 Official Patterns + เทคนิคจาก 18 Cookbooks (พร้อมค่า Threshold ตั้งต้นจริง)prior-art/INDEX.md+ 11 Shape Files — ลิงก์รวม 150+ โปรเจกต์จริงจากชุมชน แยกตามรูปร่างสถาปัตยกรรม + โค้ดตัวอย่าง
4. สรุปกฎออกแบบ Jev (11 Rules ฉบับรวบรัด) & ตัวอย่างโค้ดพร้อมใช้ (Python + TypeScript)
- One snap judgment per question: 1 คำถามต่อ 1 การตัดสินใจ แยก “โกรธ AND ขอคืนเงิน” เป็น 2 คำถามแล้วค่อยรวมเงื่อนไขในโค้ด
- รวมทุกคำถามของ State เดียวใน 1 Request (Fan-out) & เก็บ Constants ไว้ที่เดียว: คำถามเสริมแทบไม่เพิ่ม Latency (ยิงรอบ 2 เฉพาะเมื่อจำเป็นต้องใช้คำตอบแรกสร้าง State ถัดไป) พร้อมแยกคำถาม Threshold และ Weights ไว้ใน Module กลางให้คนจูนได้ง่าย
- Question IDs ไม่ได้ถูกส่งเข้าโมเดล: เขียนคำสั่งและเงื่อนไขขอบเขตทั้งหมดไว้ใน
instructionsอย่างตรงไปตรงมา เพราะ Jev อ่านตามตัวอักษรเป๊ะๆ - ส่ง State เป็น Named JSON Object & ชี้ Path ด้วย Backticks: เช่น
Does `ticket.messages[0].text` request a refund?และตัดฟิลด์ที่ไม่เกี่ยวข้องทิ้ง - Score ระดับชัดเจน + Choice ต้องมี
other/none_of_the_above+ Noul ให้high = yes: คู่กับ Noul เช็กความเกี่ยวข้อง (เช่นexists/fits) เพื่อกันการบังคับเลือกตัวผิด - ห้ามให้ Jev คิดเลข นับจำนวน จัดการวันที่ หรือเทียบสี Hex เอง: ให้โค้ดสกัด/นับ/คำนวณส่วนประกอบ แล้วส่ง Choice/Noul ย่อยเข้าช่วยแทน
- รวมธงความเสี่ยงด้วย
max()และรวมส่วนประกอบที่ต้องผ่านครบด้วยmin(): ห้ามใช้ค่าเฉลี่ยกลบจุดผิดพลาดร้ายแรง - แยก Untrusted Text ไว้ในฟิลด์เฉพาะ + ใส่ Deterministic Code Backstop เสมอ: Jev ไม่ได้ออกแบบมาป้องกัน Prompt Injection โดยลำพัง กฎ Denylist คำสั่งอันตรายต้องอยู่ในโค้ดก่อนเสมอ และ Pin รุ่น
jev-1.13.0เวลาปรับ Threshold จริงจัง
# ตัวอย่าง Python SDK (uv add typesafe-sdk | export TYPESAFE_API_KEY=...)
from typesafe_sdk import Choice, Noul, NoulCriteria, Score, TypeSafeClient

with TypeSafeClient(model="jev-1.13.0") as client:
    r = client.system_one(
        state={"ticket": {"message": "I was charged twice. Please refund ASAP."}},
        questions={
            "refund": Noul(instructions="Does `ticket.message` request a refund?"),
            "repeat": Noul(
                instructions="Has the customer contacted support about this before?",
                criteria=NoulCriteria(
                    true="Mentions a prior attempt or existing ticket",
                    false="No sign of previous contact",
                ),
            ),
            "tone": Choice(
                instructions="What is `ticket.message` tone?",
                criteria={"calm": None, "frustrated": None, "angry": None, "other": None},
            ),
            "urgency": Score(
                instructions="How urgent is `ticket.message`?",
                criteria=["Can wait a week", "Needs an answer this week", "Needs an answer today"],
            ),
        },
    )

print(r.model, r.nouls["refund"].noul, r.choices["tone"].choice, r.choices["tone"].confidence)
// ตัวอย่าง TypeScript / JavaScript SDK (npm install @typesafe-ai/sdk | Node >= 20)
import { TypeSafeClient, choice, noul, score } from "@typesafe-ai/sdk";

const client = new TypeSafeClient({ defaultModel: "jev-1.13.0" });
const { answers, model, usage } = await client.systemOne({
  state: { ticket: { message: "I was charged twice. Please refund ASAP." } },
  questions: {
    refund: noul("Does `ticket.message` request a refund?"),
    tone: choice("What is `ticket.message` tone?", { calm: null, frustrated: null, angry: null, other: null }),
    urgency: score("How urgent is `ticket.message`?", ["Can wait a week", "Needs an answer this week", "Needs an answer today"]),
  },
});
// Inferred types: answers.tone.choice, answers.tone.confidence, answers.refund.noul
5. คลัง 11 รูปแบบสถาปัตยกรรม (Prior Art 150+ โปรเจกต์) & งานที่ไม่ควรใช้ Jev
Implementation Shape (ในโฟลเดอร์ prior-art/) |
กลไกหลัก & ตัวอย่างโปรเจกต์จริงจากชุมชน |
|---|---|
control-loops.md |
ตัดสิน Action ทุก Tick ในเกม หุ่นยนต์ โดรน UI หรือตลาด (State → Choice บน Legal Actions → โค้ดรัน) |
select-from-candidates.md |
Select, don’t generate: ให้ Regex/Parser หาผู้สมัคร แล้วส่งเป็น Choice Keys ให้ Jev เลือก (Tool Call / Browser Agent) |
gates.md |
ด่าน Allow / Review / Escalate คู่กับ Deterministic Code Guard (เช่น Soter Discord Bot, คุมคำสั่ง Shell, อนุมัติโอนเงิน) |
stream-filters.md |
กรองสตรีมมหาศาลราคาถูก: sift คัดโพสต์ X/YouTube $0.00003/โพสต์, jgrep สแกน Log 1 ล้านบรรทัด ~$10, Chatwoot & Inbox Zero |
ranking-and-matching.md |
Rerank Top-30 จาก BM25 เพิ่ม Hit Rate 38% → 62% (1,200 calls = $0.0645) หรือเดินต้นไม้หมวดหมู่ >255 ตัวด้วย Beam Search |
judges-and-evals.md |
Rubric ย่อยรายข้อ, Triage โค้ด, Audit SEO 52 กฎ (AgriciDaniel/jev-seo) |
incremental-realtime.md & agent-context-memory.md |
พากย์เสียงเรียลไทม์, Keystroke UI และคัดเลือก Keep/Drop/Lease ความจำของ Agent แทนการ Summarize ทิ้ง |
llm-pairing.md, research-and-features.md & embedding-in-infrastructure.md |
จับคู่ Jev + Reasoning LLM (LangGraph Cascade), แปลง Probabilities เป็นคอลัมน์เทรน ML และฝังใน SQL / Vector DB / Home Assistant |
prior-art/INDEX.md)- หมากรุก & Puzzle ที่ต้อง Search ลึกหลายตา: Jev เป็น System One จึงพลาดทุกตาเดินที่ต้องคำนวณล่วงหน้า — ให้เก็บ Logic การ Search ไว้ในโค้ด
- Code Review โดยไม่มี LLM ตัวใหญ่ร่วมตรวจ: อ่อนเกินไปสำหรับตัดสินเหตุผลเชิงโค้ดลึกๆ (เหมาะกับ Triage/Risk Scoring เท่านั้น)
- งานมองภาพ/NSFW ภาพโดยตรง (Perception): Jev รับได้เฉพาะ Text เท่านั้น ต้องใช้โมเดล Computer Vision / OCR แปลงเป็นข้อความก่อน
- เชื่อค่า Calibration ดิบ 100% บนกรณีคลุมเครือ: บนกรณีที่มนุษย์ยังเห็นต่างกัน (Contested inputs) Jev อาจมั่นใจเกินจริง ควรเทียบความแม่นยำกับ Labeled Set ของคุณเองเสมอ (เช่น Fit Platt Scaling)
6. วิธีติดตั้งสกิล building-with-typesafe-jev & ตั้งค่า TYPESAFE_API_KEY
คุณสามารถดาวน์โหลดไฟล์ .zip จากเว็บเราแล้วแตกโฟลเดอร์ building-with-typesafe-jev/ ไปวางในโฟลเดอร์สกิลของ Agent ที่ใช้ (เช่น ~/.claude/skills/, ~/.codex/skills/, ~/.gemini/config/skills/ หรือ .agents/skills/) หรือติดตั้งผ่านคำสั่ง CLI ของแต่ละค่ายได้ทันที:
# 1) Claude Code (Plugin Marketplace)
claude plugin marketplace add aaddrick/building-with-typesafe-jev
claude plugin install building-with-typesafe-jev@building-with-typesafe-jev
# เรียกใช้ด้วยมือ: /building-with-typesafe-jev:building-with-typesafe-jev

# 2) OpenAI Codex CLI
codex plugin marketplace add aaddrick/building-with-typesafe-jev
codex plugin add building-with-typesafe-jev@building-with-typesafe-jev

# 3) Muse (muse.ai) & Muse Code
curl -fsSL https://raw.githubusercontent.com/aaddrick/building-with-typesafe-jev/main/scripts/install_muse.sh | bash

# 4) (แนะนำ) ตั้งค่า TYPESAFE_API_KEY บน macOS (zsh) ให้ Agent Shell มองเห็นทุกเซสชัน
mkdir -p ~/.config/typesafe && umask 077 && printf 'export TYPESAFE_API_KEY=%s\n' 'YOUR_KEY' > ~/.config/typesafe/env
echo '[ -f ~/.config/typesafe/env ] && . ~/.config/typesafe/env' >> ~/.zshenv
# หมายเหตุ: ~/.zshenv ถูกอ่านโดย Non-interactive shell ที่ AI Agent เปิดขึ้น (ต่างจาก ~/.zshrc)
ดาวน์โหลดสกิลฟรี & ต่อยอดการออกแบบ AI Agent ระดับโปรดักชัน
โหลดชุดสกิล building-with-typesafe-jev ฉบับเต็ม 16 ไฟล์ฟรี ดูคลัง Agent Skills ทั้งหมดบนเว็บ หรือเรียนออกแบบสถาปัตยกรรม Agent กับ อ. Kevin